Több amerikai techcég részvénye is zuhanórepülésbe kezdett a tőzsdén a hétfői piacnyitáskor. A mesterségesintelligencia-verseny egyik eddigi nagy nyertese, a csúcstechnológiás chipeket gyártó Nvidia egyetlen nap alatt mintegy 300 milliárd dollárt vesztett becsült piaci értékéből, ami a valaha volt legnagyobb esés az amerikai tőzsdetörténelemben. Nem az Nvidia volt ugyanakkor az egyetlen, mely komoly zuhanást könyvelt el: a chipgyártó gépekért felelős holland ASML részvényei 8,5 százalékkal, a Microsofté pedig 6 százalékkal estek, és akkor a Siemens 22 százalékos bukásáról még nem is beszéltünk.
Az alig több mint másfél éves múltra visszatekintő, lényegében ismeretlen ázsiai cég ugyanis egy olyan fejlett érvelő modellel állt elő január 20-án, Donald Trump amerikai elnök beiktatásának napján, mely a dokumentáció és a benchmark tesztek szerint képes felvenni a versenyt az OpenAI, az Anthropic, a Google és a Meta fejlesztéseivel, sőt egyes feladattípusokban le is győzi őket. És ezt az eredményt az amerikai cégek befektetéseinek töredékéért tudták elérni: a hivatalos kommunikáció szerint az R1 elnevezésű érvelő modell betanítási költsége mindössze 6 millió dollár volt, míg például a Meta 65 milliárd dollárt tervez csak idén erre a célra fordítani.
A világsajtóban az amerikai mesterségesintelligencia-ipar Szputnyik-pillanataként hivatkoznak erre az eseményre, ami az ötvenes évek űrversenyére utal, amikor is mindenki megdöbbenésére a szovjetek előbb tudtak műholdat küldeni az űrbe, mint az amerikaiak. A lapunknak megszólaló nemzetközi mesterségesintelligencia-szakértő, Dr. Tilesch György kiemelte: a DeepSeek feltűnése elsősorban geopolitikai manőver volt, és az amerikai big tech cégek elkényelmesedésére volt válaszreakció. Ez pedig várhatóan azt eredményezi majd, hogy az amerikai techcégek is nagyobb energiát fordítanak a modelljeik hatékonyságára.

Mit tudni a kínai csodacégről?
A DeepSeek egy kínai hedge fund vállalatból nőtt ki alig több mint másfél évvel ezelőtt, amit szintén Liang Wenfeng, az MI-fejlesztő cég vezetője alapított. A kommunista államban működő vállalatról, mivel elég kevés információ áll rendelkezésre, csupán a hivatalos dokumentációból tudhatunk meg néhány dolgot: a képzési adatok nagyrészt szintetikusak, azaz más fejlesztések, például a ChatGPT faggatásából, úgynevezett promptolásából származnak. A modell betanítása nagyjából két hónapot vett igénybe, és 6 millió dollárba került, ami eltörpül az OpenAI és a többi cég 100 millió és 1 milliárd dollár közötti befektetéseihez képest.
Mégis úgy tűnik, igencsak potens szereplővel van dolgunk: matematikai műveletek és szoftverfejlesztés terén például jobb eredményeket tudott felmutatni, mint a konkurens amerikai cégek fejlesztései – a méréseket persze érdemes kétkedve fogadni. Annál is inkább, ugyanis kínai modell lévén pontosan látszik, milyen pontokon nyúlhattak bele a betanításba: Makay József kiberbiztonsági szakértő például arról számolt be, hogy a Kínai Kommunista Párt számára kellemetlen témákban, így az ujgurok helyzetét és a Tienanmen téri vérengzést érintő kérdésekben érezhetően kitérő vagy hamis válaszokat ad a fejlesztés.
A kínai vállalat jelenleg három terméket tett nyilvánosan elérhetővé: az első a decemberben kiadott DeepSeek V3 elnevezésű modell volt, ami nagyjából azt tudja, mint az OpenAI GPT-4 fejlesztése. Ezt követően január 20-án tették közzé a már említett érvelő modellt, a tőzsdén elért robbantást követően pedig január 27-én egy Janus Pro elnevezésű képgeneráló szoftverrel is előálltak, mely a cég állítása szerint jobb, mint az OpenAI DALL-E 3 és a Stability AI Stable Diffusion elnevezésű generatív mesterséges intelligenciái.
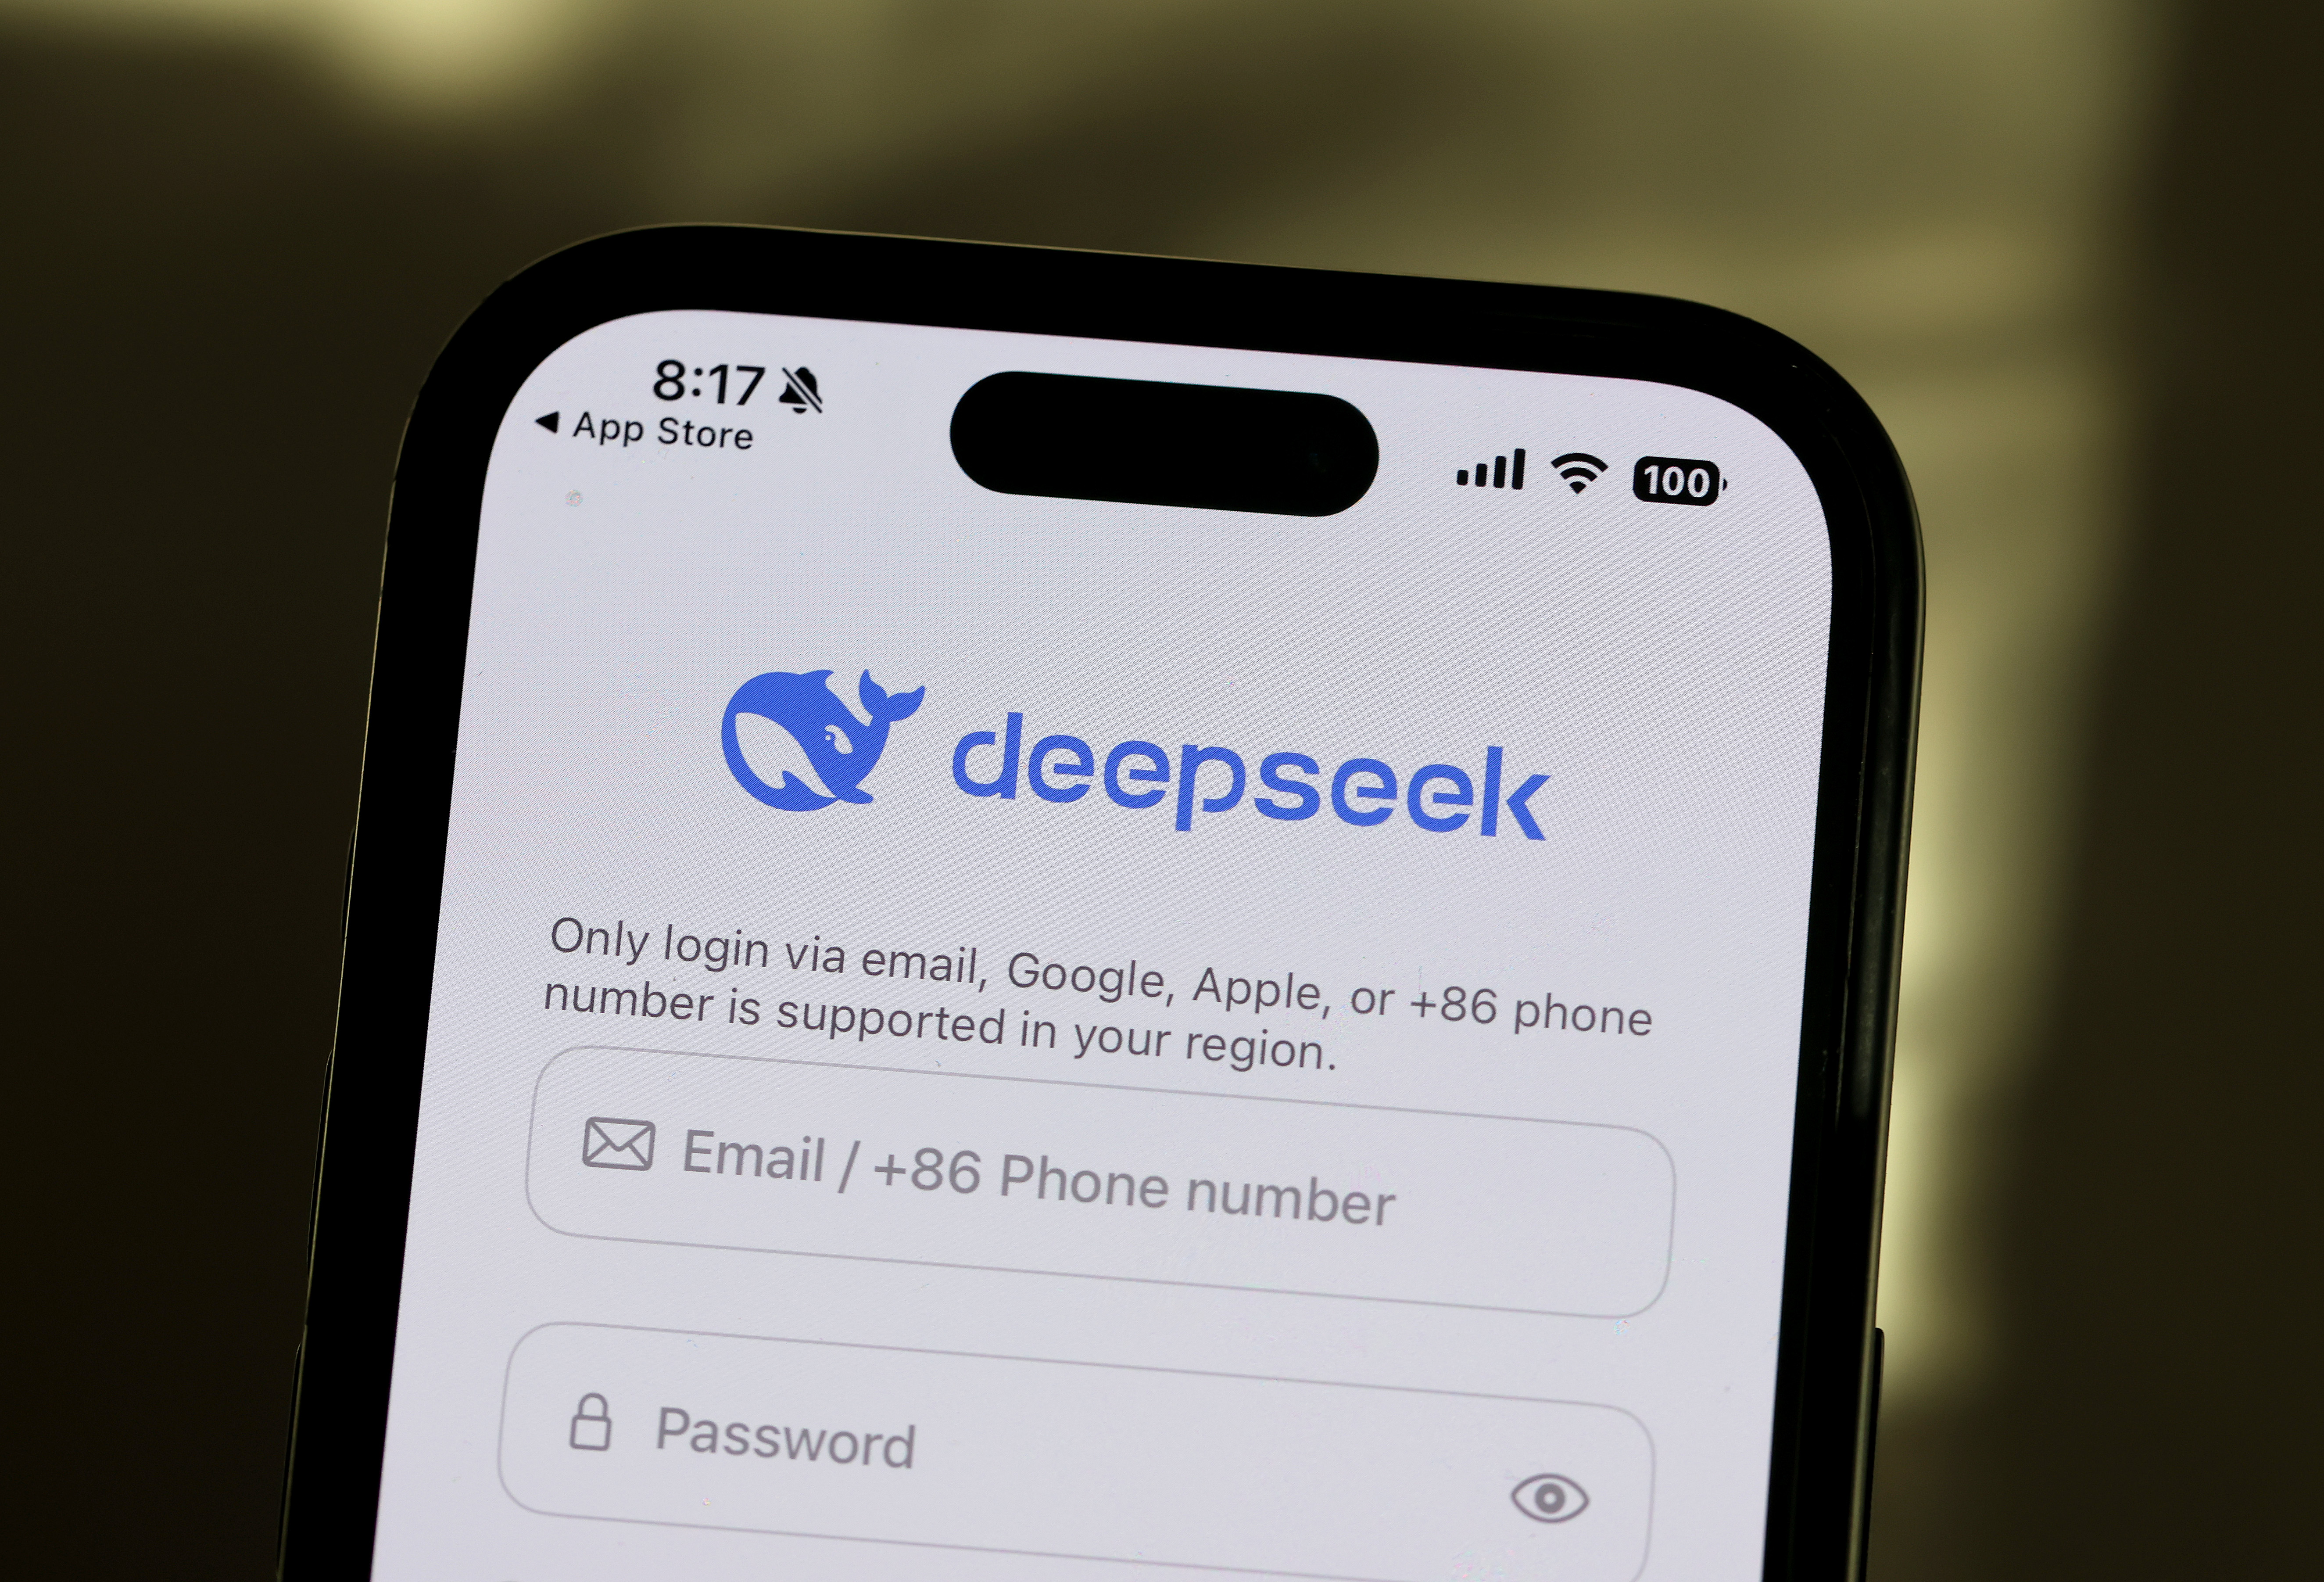
Fontos azonban kiemelni, hogy a DeepSeek alkalmazás és webes felület a világ számos pontján éppen nem használható, ugyanis a cég szerint komoly támadások érték a céget az amerikai tőzsdei adatok megjelenésekor. Ez azonban sokak szerint nem a támadások miatt van, hanem azért, mert nem bírnak megbirkózni a felhasználói igényekkel.
Tilesch György szerint a cég stratégiája, hogy azt állítják magukról, minden kutatásuk átlátható, szemben az amerikai vetélytársakéval, a probléma viszont az, hogy „ezeket az információkat nagyon nehéz verifikálni”. Azáltal pedig, hogy ma már csak kínai telefonszámmal érhető el a felület, üzleti sikernek biztosan nem mondható. A szakértő szerint ez az akció tehát arra volt jó, hogy megmutatták, Kína is jelen van az MI versenyben, ráadásul komoly eredményekkel, most viszont egy időre várhatóan megint „visszahúzódnak a csigaházba”.
A hatékonyság lesz a kulcsszó
Kína technológiai fejlesztéseiről viszonylag keveset lehet hallani, az információk ugyanis államilag koordinált mértékben és tempóban jutnak csak ki a nyugati világba és az itteni felhasználókhoz. Éppen ezért volt hatalmas meglepetés a DeepSeek sikere, amelynek hatása viszonylag gyorsan elérte az amerikai és brit fogyasztókat is: csupán január 15-én tették nyilvánosan elérhetővé az alkalmazást a Google és az Apple alkalmazásboltjaiban, alig másfél héttel később viszont az almás boltban már az első helyen volt, lenyomva a ChatGPT-t és a Google-féle Geminit. Mindezt úgy sikerült véghez vinnie a cégnek, hogy a rendelkezésére álló eszközök terén óriási lemaradásban van az amerikai riválishoz képest.
2022-ben ugyanis az Egyesült Államok partnereivel együtt exportkorlátozásokat vezetett be Kínával szemben, melynek következtében nem juthattak el az ázsiai országba a legfejlettebb félvezető-technológiák. Ezzel az intézkedéssel az volt az amerikaiak és a szövetséges japánok, illetve hollandok célja, hogy meggátolják a kínai félvezetőgyártás fellendülését, és korlátozzák az MI-infrastruktúra fejlesztését is. Igen ám, de ez a DeepSeek példája alapján nem járt sikerrel, ugyanis az ázsiaiak így arra kényszerültek, hogy gyengébb technológiával is képesek legyenek komoly teljesítményt elérni, ami a hétfői piaci sokk alapján sikerült is.
A PHI Institute alapítója és az EY vezető AI-szakértője lapunknak nyilatkozva azt mondta, a DeepSeek semmilyen forradalmi újítást nem hozott, csupán annyit mutattak meg, hogy le lehet csökkenteni a betanítási költségeket olyan algoritmikus innovációk révén, amiket az amerikai techcégek eddig „lustaságból” nem tettek meg. Ilyen például az, hogy a kínai fejlesztésben az egyes feladatokhoz csak kisebb részeket aktiválnak a neurális hálózatból, amelyből adódóan a fogyasztás is sokkal alacsonyabb. A tekintetben pedig fejlettebbnek is mondható a kínai fejlesztés, hogy míg napjainkban egy átlagos amerikai modell egy-két tokent, vagyis soron következő elemet tudnak prediktálni, addig a DeepSeeknél ez akár három is lehet.
Tilesch azonban kijelentette: nem valószínű, hogy a DeepSeek a hétfőinél nagyobb földindulást tudna okozni.
Kína megmutatta, hogy ilyet is tud, de a piacaik és a csatornáik sincsenek meg arra, hogy egy ilyen szolgáltatást rentábilisan működtessenek. Márpedig ez egy nagyon fontos kérdés. A modellt olcsón betanítani egy dolog, de a rendszer működtetéséhez azok a GPU-k kellenek, amik nekik nincsenek meg.
Mi lehet Amerika válasza?
A szakértő szerint a kialakult helyzetre az Egyesült Államoknak két válasza lehet. Az egyik, amit nem sokkal ezelőtt Donald Trump is megpedzegetett, vagyis hogy ha a kínaiak meg tudják csinálni olcsóbban, akkor az amerikai cégeknek is képesnek kell lenniük erre. Így várhatóan hamarosan elkezdődik egyfajta hatékonysági vagy miniatürizálási verseny, aminek a legnagyobb győztese a bolygónk lehet. Jelenlegi formájában ugyanis az MI fejlesztése óriási energiaigénnyel jár: nem véletlen, hogy a Microsoft és sokan mások már saját atomerőmű építését tervezték az adatközpontok üzemeltetésére – a nagy amerikai techcégek pusztító hatásával ebben a cikkünkben részletesen foglalkoztunk.
Az MI-szakértő szerint erre minden oka meg is lehet az amerikai kormányzatnak, ugyanis ahogy az a Wired cikkéből is kiderül, a DeepSeek a felhasználói adatokat Kínában dolgozza fel, ami a TikTok esetében is felvetette a nemzetbiztonsági kockázat kérdéskörét. Tilesch emellett jelezte, hogy a program kódolási asszisztense aktívan mutat olyan könyvtárak felé is, melyek köztudott kínai exploitok, másnéven támadókódok, amelyek alkalmasak bizonyos biztonsági rések kihasználására.
Kína tehát egy komoly fricskát mutatott az óriásvállalatoknak, amiért most a befektetők megbüntetik a cégeket: ennek volt köszönhető a hétfői bezuhanás a tőzsdén. Kérdésünkre, miszerint tartós hanyatlást okozhat-e az amerikai cégek értékében a DeepSeek feltűnése, Tilesch György azt mondta, az AI-turmix tetején mindig is volt egy 10–15 százaléknyi hab, amit nyugodtan le lehet szedni, ez pedig most meg is történt. A keddi napon emelkedésről nem, stabilizálódásról azonban lehet beszélni, az Investopedia szerint azonban még semmi nincs kőbe vésve, és nem lehet kizárni egy újabb eladási hullámot.
but mostly we are excited to continue to execute on our research roadmap and believe more compute is more important now than ever before to succeed at our mission.
the world is going to want to use a LOT of ai, and really be quite amazed by the next gen models coming.
— Sam Altman (@sama) January 28, 2025
Az amerikai elnök nyilatkozata alapján már leszűrte a DeepSeek okozta a sokkból a tanulságot, azonban az OpenAI egyelőre úgy tűnik, nem. Az amerikai cég vezetője, Sam Altman ugyanis az X-en közzétett bejegyzésében azt írta, jó érzés, hogy erős kihívójuk akadt, de azt ígérte: a jövőben még jobb modellekkel fognak előállni, a cége pedig továbbra is hisz abban, hogy a még több számítási kapacitás fontosabb a siker érdekében, mint valaha. A lapunknak megszólaló szakértő szerint nem lehet kérdés, hogy meg fog jelenni – a befektetők oldaláról pedig láthatóan már meg is jelent – egy olyan igény, hogy optimalizálják az MI-fejlesztést, amelynek egyik legfontosabb projektje a nemrégiben Trump által bejelentett, 500 milliárd dolláros Stargate Project.
A CNBC műsorában azt is hangsúlyozták, hogy a kínai cégek közül egyáltalán nem csak a DeepSeek az, amely képes hatékonyabban betanítani nyelvi modelljeit. Ott van például Kai Fu Lee, a Google kínai érdekeltségeinek korábbi vezetője, aki 01.AI elnevezésű cégével mindössze 3 millió dollárból készített egy szintén igencsak fejlettnek mondható nyelvi modellt. Az egyik legnagyobb kínai vállalat, az Alibaba pedig arról számolt be 2024 végén, hogy mintegy 85 százalékkal tudta csökkenteni a nyelvi modellek képzésének költségeit. Az Egyesült Államok techcégeinek tehát van miben fejlődniük a kínai kihívókhoz mérten.